
VLM 영상분석: 기존 AI CCTV와 무엇이 다른가
VLM 영상분석은 CCTV 장면을 문장으로 읽고 문장으로 찾는 방식입니다. 기존 AI CCTV 탐지와의 차이, 오탐 판정과 자연어 검색에서 달라지는 점, 도입 전에 확인할 조건을 정리했습니다.

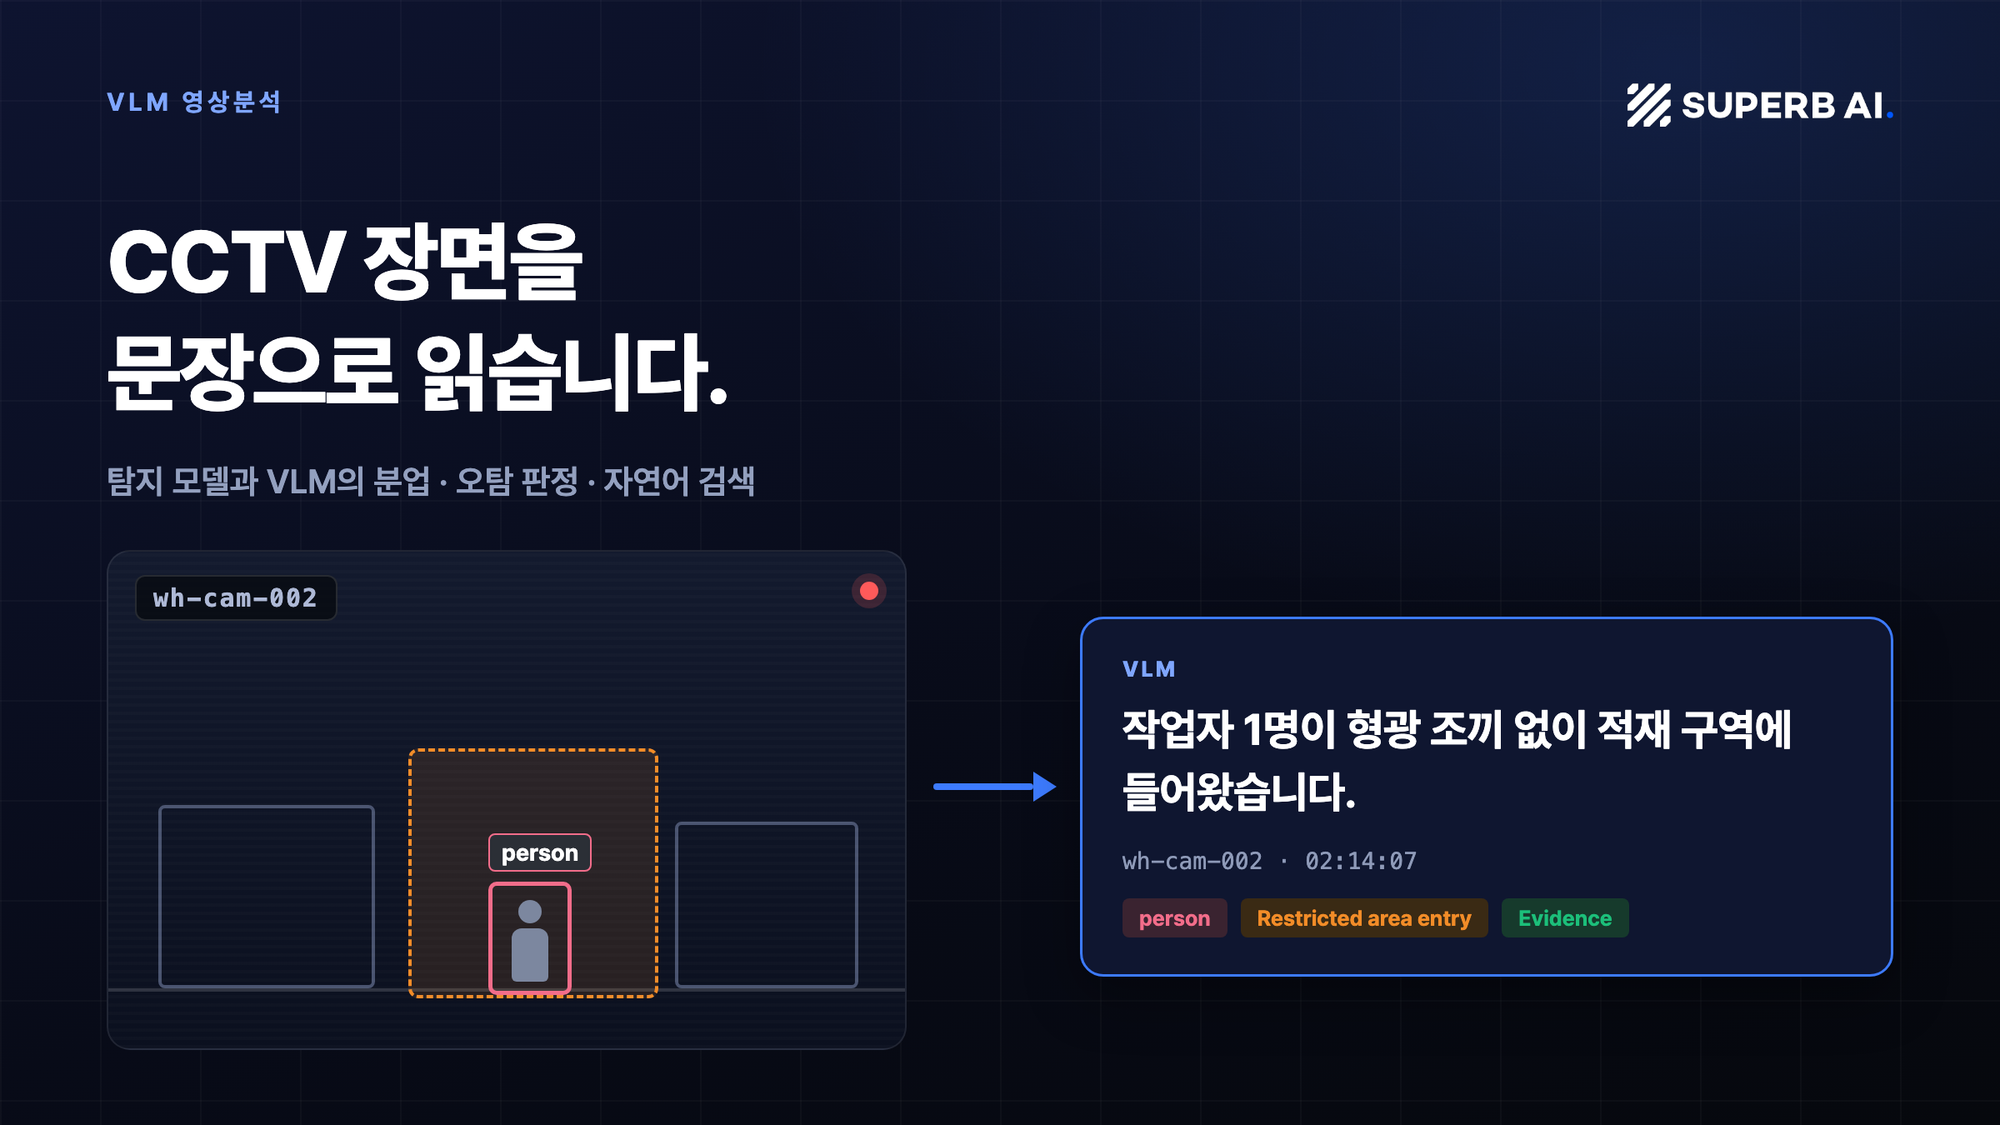
VLM 영상분석은 영상과 문장을 함께 학습한 시각언어모델(VLM)이 CCTV 장면을 문장으로 읽고 문장으로 찾는 영상분석 방식입니다. 기존 AI CCTV의 객체 탐지 모델은 화면 속 사람·차량·불꽃에 박스를 치고 정해진 규칙에 걸리면 알림을 냅니다. VLM은 같은 장면에서 무슨 일이 벌어지는지를 문장으로 내놓습니다. 출력이 박스에서 문장으로 바뀌면 오탐을 거르는 방법, 녹화 영상을 찾는 방법, 서버와 장비를 준비하는 조건이 함께 바뀝니다. 이 글은 두 방식의 차이와 함께 쓰는 구조, 도입 전에 확인할 조건을 정리합니다. 이 글은 2026년 11월 기준으로 작성했습니다.
📌 3줄 요약
· 기존 AI CCTV의 탐지 모델은 "무엇이 어디에 있는가"를 박스로 답하고 VLM은 "무슨 일이 벌어지는가"를 문장으로 답합니다. 두 모델은 한 시스템 안에서 역할을 나눕니다.
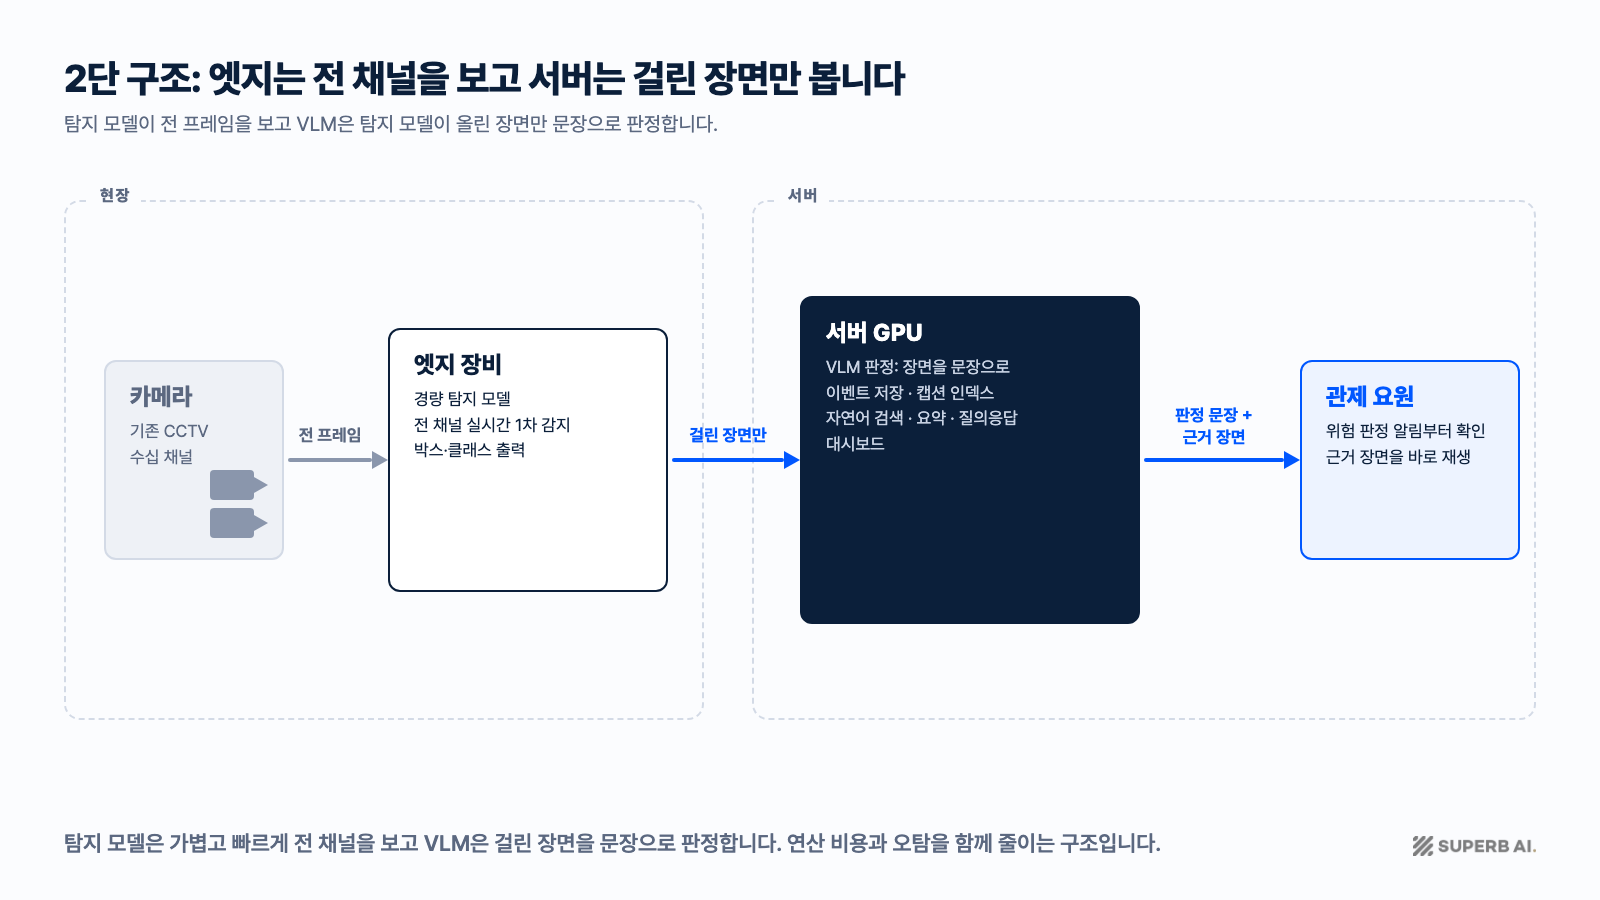
· 실무 구조는 2단입니다. 엣지 장비의 경량 탐지 모델이 전 채널을 실시간으로 보고 걸린 장면만 서버의 VLM이 다시 판정합니다. 오탐을 거르면서 연산 비용을 감당하는 구조입니다.
· 자연어 검색·요약·질의응답은 VLM이 새로 여는 기능입니다. 녹화 영상에서 "안전조끼 없이 적재 구역에 들어간 사람"을 문장으로 찾고 교대 시간에 하루치 이벤트를 문장 목록으로 넘깁니다.
두 방식의 차이: 박스를 내는 모델과 문장을 내는 모델
AI CCTV에 쓰이는 모델은 출력으로 가릅니다. 사람·차량·불꽃처럼 정해진 대상을 학습해 박스를 치는 객체 탐지 모델, 탐지 대상을 문장으로 정의하면 학습 없이 박스를 치는 제로샷 탐지 모델, 장면을 보고 문장을 내는 VLM입니다. 앞의 둘은 무엇이 어디에 있는지를 답하고 VLM은 무슨 일이 벌어지는지를 답합니다.
| 구분 | 객체 탐지 모델 | 제로샷 탐지 모델 | VLM 영상분석 |
|---|---|---|---|
| 입력 | 프레임 | 프레임 + 탐지 대상 문장 | 프레임이나 구간 + 질문·지시 문장 |
| 출력 | 박스·클래스·신뢰도 | 박스·클래스 | 문장(설명·요약·답변) |
| 새 대상 추가 | 데이터 수집·라벨링·재학습 | 대상을 문장으로 정의 | 질문을 바꿈 |
| 강점 | 가볍고 빠름, 엣지 구동, 수치화 쉬움 | 학습 없이 시작 | 상황·맥락 판단, 검색·요약 |
| 약점 | 학습한 클래스만 인식, 상황 판단 없음 | 복잡한 행동·맥락 판단은 한계 | 연산 비용 큼, 전 프레임 실시간 처리에 부적합, 틀린 문장을 낼 수 있음 |
| 주 용도 | 실시간 1차 감지, 카운팅 | 이벤트를 빠르게 시작할 때 | 2차 판정, 녹화 검색, 요약, 보고 |
AI CCTV 영상관제 가이드에서 비교한 학습형 AI와 학습 없는 AI는 둘 다 탐지 층입니다. VLM은 그 위에 얹는 판독 층입니다. NVIDIA도 비디오 분석 AI 에이전트 소개에서 VLM을 에이전트의 두뇌 자리에 놓고 VLM·LLM·검색 증강 생성을 묶어 자연어로 영상을 검색하고 요약하는 구조를 제시합니다. 로봇 분야에서 VLM이 맡는 역할은 VLA·RFM·WFM·VLM 비교 글에 정리했습니다.
오탐: 탐지 모델이 올린 장면을 VLM이 다시 봅니다
AI CCTV 오경보의 원인은 대개 조명 변화, 그림자, 수증기와 연무, 유리 반사, 비슷한 모양의 물체입니다. 탐지 모델은 박스를 치는 일에 능하지만 그 박스가 위험한 상황인지는 모릅니다. 지금까지의 처방은 두 가지였습니다. 민감도와 구역 경계를 조정하거나 현장 데이터로 다시 학습하는 방법입니다. 전기차 화재 초기 연기처럼 감지 대상이 특수하면 지금도 이 길이 맞습니다. 국립소방연구원 사례는 10만 장 규모 데이터셋으로 학습한 전용 모델로 오경보율을 80% 낮췄습니다(사례 글).
VLM은 세 번째 처방을 더합니다. 탐지 모델이 알림을 올린 장면을 VLM이 문장으로 판독합니다. "배관에서 수증기가 올라옴, 불꽃 없음"이나 "사람이 통제 구역 안에 있으나 작업 허가 조끼를 착용함" 같은 판정이 붙으면 관제 요원은 VLM이 위험으로 판정한 알림부터 확인합니다. 나머지는 기록으로 남깁니다.
VLM을 모든 카메라의 모든 프레임에 돌리지 않는 이유는 연산 비용입니다. 탐지 모델이 처리하던 프레임을 그대로 VLM에 넣으면 서버 연산이 크게 늘어납니다. 그래서 실무 구조는 2단으로 굳어졌습니다. 슈퍼브 영상 관제 솔루션의 구성도 같습니다. 카메라 영상은 현장의 엣지 장비(NVIDIA Jetson 계열)에서 1차 탐지를 거치고 이벤트가 걸린 장면만 서버로 올라갑니다. 서버가 VLM 판정, 이벤트 저장, 대시보드 표시를 맡습니다.
자연어 검색: 문장으로 녹화 영상을 찾습니다
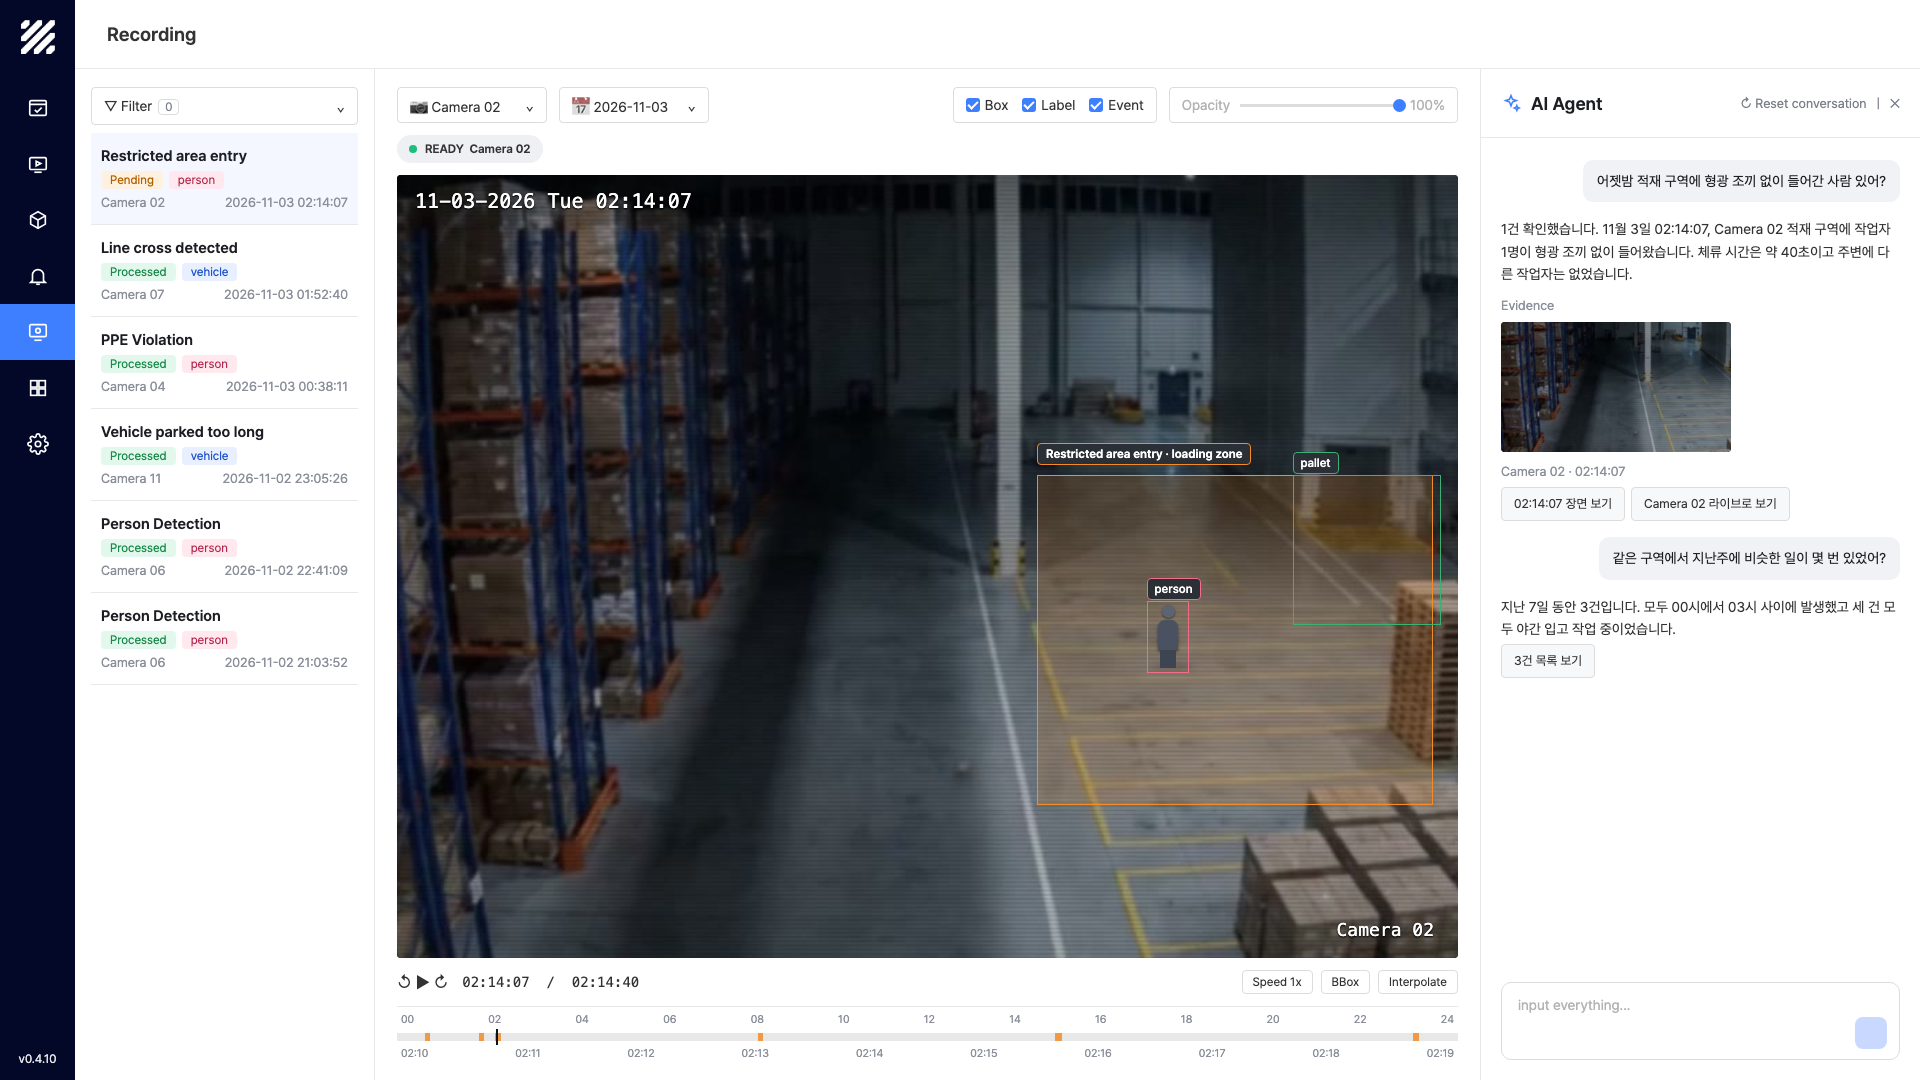
기존 AI CCTV에서 녹화 영상을 찾는 방법은 카메라, 시간대, 이벤트 종류 필터였습니다. 어젯밤 적재 구역에 누가 들어왔는지 알려면 사람이 그 구간을 돌려봐야 했습니다. VLM은 이벤트마다 문장을 남깁니다. "작업자가 안전모를 착용하지 않고 위험구역에 진입함"처럼 시각과 맥락이 들어간 캡션입니다. 문장이 쌓이면 세 가지가 가능해집니다.
- 검색: "형광 조끼 없이 적재 구역에 들어간 사람"을 문장으로 입력해 해당 장면을 찾습니다.
- 요약: 야간 근무 동안 발생한 이벤트를 문장 목록으로 받아 교대 인수인계에 씁니다.
- 질의응답: "지난주 지게차 과속 알림이 가장 많았던 시간대는?"처럼 쌓인 이벤트 기록을 물어 집계와 차트로 받습니다.
제로샷 탐지와 헷갈리기 쉽습니다. "형광 조끼를 입지 않은 사람"이라는 같은 문장을 실시간 감시 규칙으로 등록하면 제로샷 탐지이고 녹화 영상에서 찾으면 VLM 검색입니다. 앞은 지금부터 걸러내는 일이고 뒤는 이미 찍힌 것을 찾는 일입니다. 슈퍼브 영상 관제 솔루션의 텍스트 검색 기능 소개는 자율 관제 글에 있습니다.
실측: 현장에서 VLM이 맡은 일과 맡기지 않은 일
| 현장 | 탐지 층 구성 | VLM 역할 |
|---|---|---|
| 인천국제공항 여객 흐름 관리 개념 검증 (2025) | 탐지와 재식별로 여객 이동 경로·대기 시간 산출 | 방대한 영상에서 중요 장면 추출, 이상 상황 식별, 자연어 질의로 영상 분석 |
| 김천시 스마트시티 관제 | 현장 데이터로 학습한 모델과 프롬프트 기반 모델의 하이브리드, 14종 | 없음: 탐지 층만으로 안전·교통 이벤트 관제 |
| 국립소방연구원 전기차 화재 조기 감지 | 10만 장 데이터셋 학습형 검출기, 감지 시간 65% 단축·오경보율 80% 감소 | 없음: 초기 연기처럼 빠르고 특수한 감지는 전용 검출기 |
세 현장 중 VLM을 쓴 곳은 인천국제공항입니다. 공항 전역의 카메라에서 상황을 문장으로 찾아야 하는 과제였습니다. 나머지 두 현장은 탐지 층만으로 과제를 풀었습니다. 감지 대상이 정해져 있고 빠른 알림이 핵심이면 VLM이 끼어들 자리가 없습니다.
공공 수요는 문장으로 전달하는 관제 쪽으로 움직입니다. 과학기술정보통신부와 한국지능정보사회진흥원은 2026년 7월 총 116억8,000만 원을 들여 공공 CCTV 1만8,100여 대를 국산 NPU 기반 AI 분석으로 전환하는 사업을 발표했습니다(뉴시스 2026-07-28). 관제센터 서버가 영상을 실시간 분석해 위험 상황의 세부 내용을 문장으로 관제요원에게 전달하는 방식입니다. 상황 설명을 문장으로 받는 관제가 공공 조달 요건에 들어오기 시작했다는 신호입니다.
VLM이 있으면 탐지 모델 학습이 필요 없나요?
탐지 모델은 계속 필요합니다. 수십 개 채널을 실시간으로 보는 일은 가볍고 빠른 탐지 모델의 몫이고 VLM은 걸린 장면만 봅니다. 감지 대상이 특수하면 전용 모델 학습이 여전히 가장 확실한 길입니다. VLM은 오탐 확인과 녹화 검색에 드는 사람의 시간을 줄입니다.
기존 AI CCTV 서버에 VLM을 붙일 수 있나요?
네 가지를 확인하면 됩니다.
- 서버 GPU: VLM은 서버 쪽에서 돌아갑니다. 엣지 장비에는 탐지만 맡기고 서버에 GPU를 둡니다. 채널 수와 이벤트 발생량이 서버 사양을 정합니다.
- 영상 저장과 인덱스: 문장 검색은 이벤트 클립과 캡션을 저장해야 가능합니다. 보관 기간이 곧 검색 범위입니다.
- 영상이 머무는 곳: 영상을 현장 밖으로 내보내지 못하는 사업장은 온프레미스 서버 구성을 택합니다. 클라우드 구성도 가능하고 어느 쪽이든 얼굴·번호판 비식별화를 함께 둡니다. 구성별 차이는 비전 AI 배포 방식 가이드에 있습니다.
- 카메라 화질: 캡션과 검색 품질이 화질을 따라갑니다. 기존 CCTV는 대부분 그대로 쓰되 저조도·저해상도 구역은 인프라 진단에서 가려냅니다. 야간 저조도 카메라는 캡션이 거칠어 검색 품질이 먼저 떨어집니다.
비용 구조는 이벤트 수와 현장 수가 견적을 정하는 기존 구조 그대로이고 서버 GPU 항목이 더해집니다.
오탐이 완전히 사라지나요?
줄어들지만 사라지지는 않습니다. VLM도 가려짐, 저조도, 낮은 화질에서 틀리고 그럴듯하게 틀린 문장을 낼 때가 있습니다. 그래서 판정 문장마다 근거 장면이 붙어야 합니다. 어느 카메라의 몇 시 몇 분 프레임을 보고 낸 판정인지가 함께 저장되면 사람이 한 번에 확인합니다. 도입 첫 2~4주는 탐지 모델과 같은 방식으로 오탐·미탐을 점검하고 알림 임계치를 현장에 맞춥니다. 점검 절차는 허브 글의 도입 4단계와 같습니다.
VLM 영상분석을 검토할 때 볼 것 세 가지
첫째, 지금 겪는 문제가 놓침인지 오탐인지 봅니다. 놓침이 문제라면 탐지 모델 보정이 먼저입니다. 오탐 확인과 사건 조사에 사람의 시간이 들어간다면 VLM이 맞습니다.
둘째, 영상이 어디서 분석되고 어디에 남는지 봅니다. 엣지 탐지와 서버 VLM의 2단 구조에서 서버를 현장 안에 둘지 클라우드에 둘지가 보안 요건과 비용을 함께 정합니다.
셋째, VLM의 답에 근거 장면이 붙는지 봅니다. 문장만 나오는 시스템은 확인에 다시 시간이 듭니다. 판정과 검색 결과마다 카메라와 시각이 붙어 바로 재생되는지 데모에서 확인합니다.
슈퍼브에이아이는 산업 현장의 시각 데이터를 기업이 활용할 수 있는 인텔리전스로 전환하는 비전 인텔리전스 기업입니다. 기존 CCTV 위에 엣지 탐지 모델과 서버 시각언어모델을 함께 운영하는 슈퍼브 영상 관제 솔루션과 산업 특화 비전 파운데이션 모델 제로(ZERO)를 제공합니다.
💬 VLM 영상분석 도입을 검토하고 계신가요? 아래에 카메라 대수와 가장 자주 겪는 오경보 유형을 남겨주시면, 영업 전화가 아니라 기존 영상으로 가능한 판정·검색 범위 진단부터 시작합니다.