
산업 특화 비전 파운데이션 모델 제로(ZERO): 학습 없이 시작하는 산업 비전 AI
산업 특화 비전 파운데이션 모델 제로(ZERO)를 소개합니다. 사전 학습 없이 텍스트와 이미지 프롬프트로 산업 현장의 객체를 탐지하는 원리와 CVPR 2026 1위로 검증된 성능, 도입 절차를 정리했습니다.

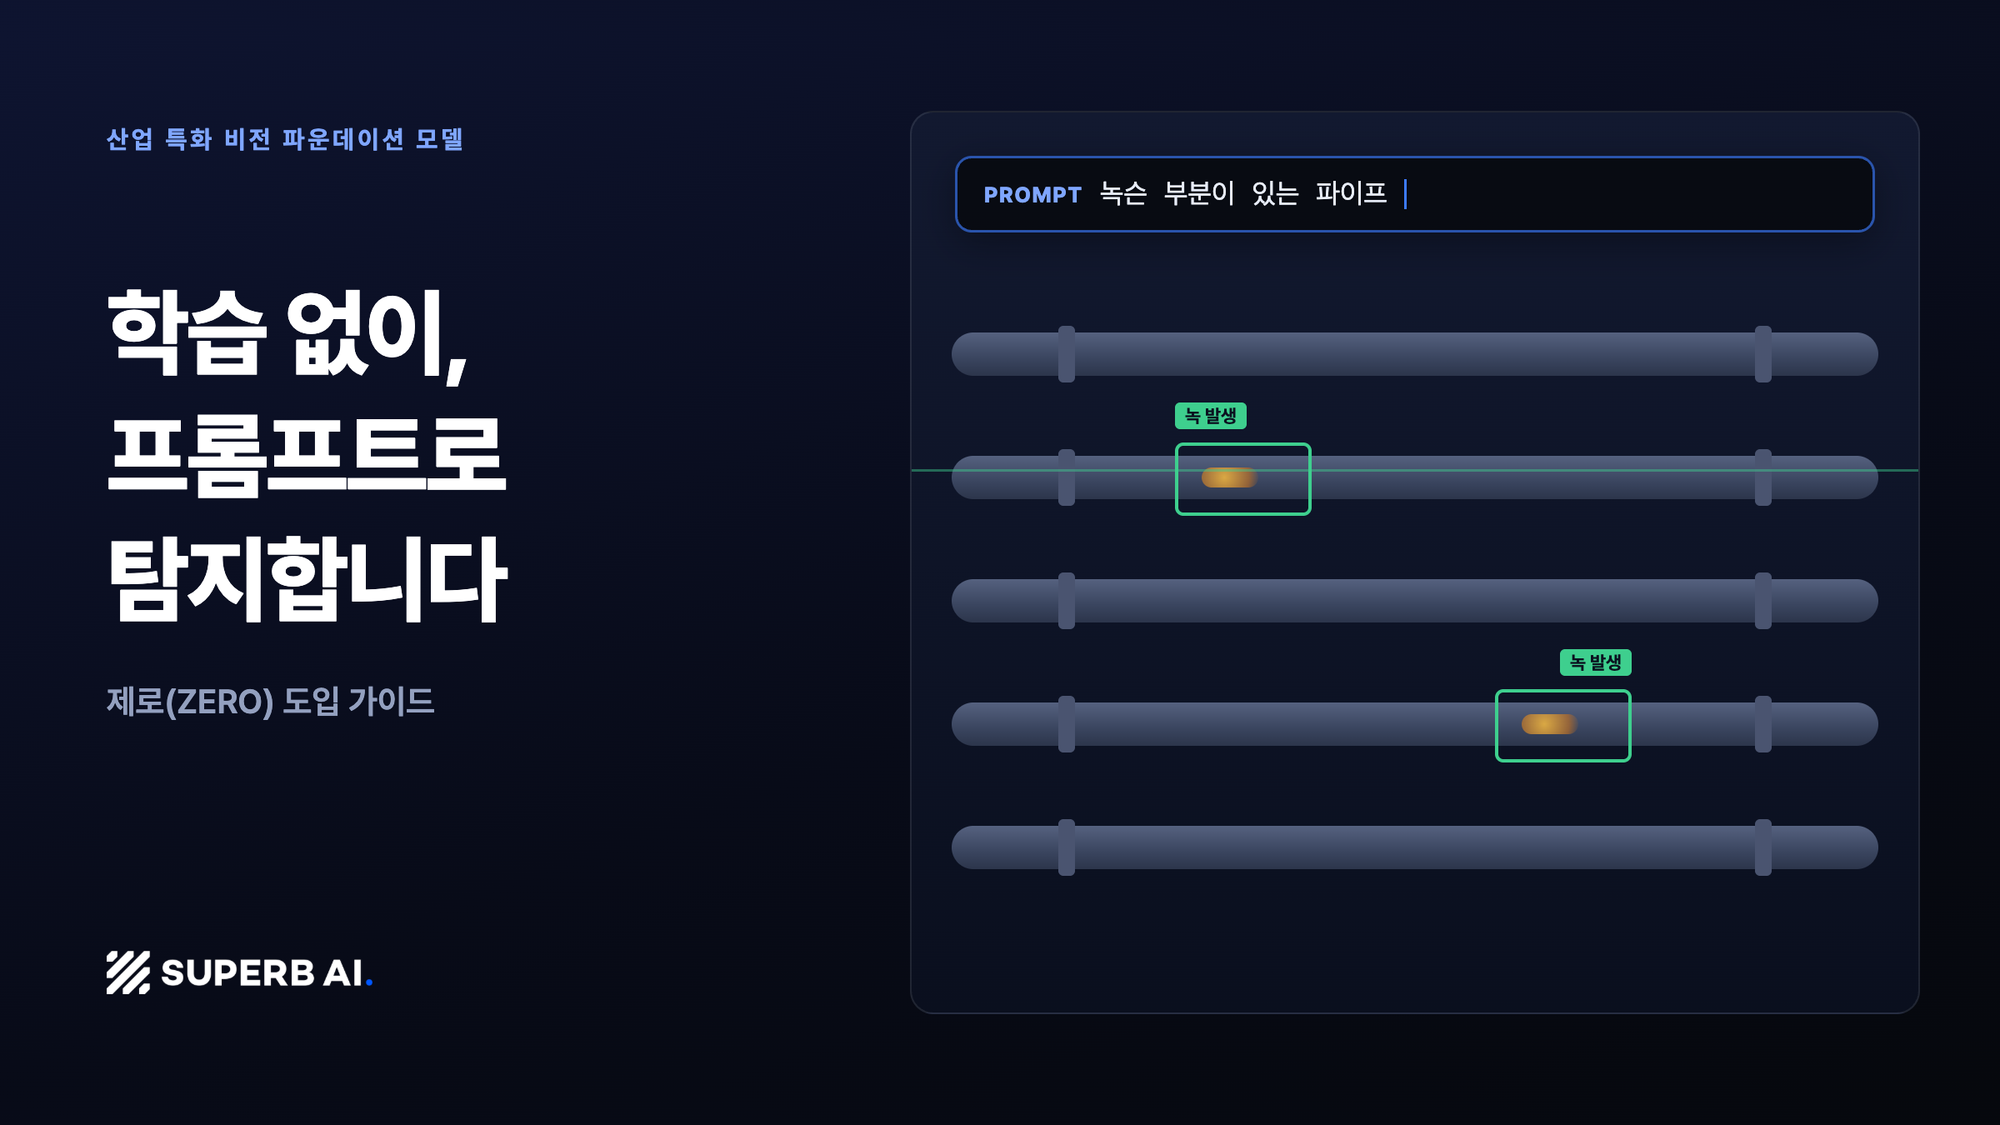
산업 특화 비전 파운데이션 모델 제로(ZERO)는 별도의 데이터 라벨링이나 모델 학습 없이, 텍스트나 이미지 프롬프트만으로 산업 현장의 객체를 탐지하는 비전 파운데이션 모델(Vision Foundation Model, VFM)입니다. 기존 비전 AI는 학습한 것만 인식하는 닫힌 세계(Closed-set)에 갇혀 있어 새로운 불량 유형이나 환경 변화가 생기면 데이터 수집과 재학습을 반복해야 했습니다. 제로는 "녹슨 부분이 있는 파이프"나 "안전선 밖에 있는 작업자"처럼 자연어로 지시하면 해당 객체의 위치와 영역을 즉시 찾아냅니다.
📌 3줄 요약
· 제로는 라벨링·학습 없이 프롬프트만으로 산업 객체를 탐지하며, 신규 대상 대응이 재학습에서 프롬프트 수정으로 바뀝니다.
· CVPR 2026 파운데이션 퓨샷 객체 탐지 챌린지에서 mAP 53.9로 1위를 기록했습니다(2위 51.6, 베이스라인 33.3).
· 온프레미스와 엣지 환경에서 구동되도록 설계되어, 민감한 산업 데이터를 외부로 보내지 않고 현장에서 처리합니다.
산업 현장의 오랜 문제: AI가 현장 변화를 못 따라간다
AI 도입을 검토한 현장이라면 익숙한 문제들이 있습니다. 데이터 수집과 라벨링에 드는 시간과 비용, 제한된 학습 데이터로 인한 낮은 범용성, 신제품이나 환경 변화 앞에서 급락하는 성능. 원인은 같습니다. 기존 비전 AI는 학습 시점의 세계에 고정되기 때문입니다.

비전 파운데이션 모델은 이 구조를 바꿉니다. LLM(거대 언어 모델)과 VLM(비전 언어 모델)이 AI의 언어와 이해를 담당한다면, VFM은 현실 세계를 보고 위치까지 짚어내는 눈의 역할입니다. 피지컬 AI(Physical AI)와 에이전틱 AI가 현장에서 작동하려면 이 눈이 필수입니다. 슈퍼브에이아이가 국내 최초로 산업 특화 VFM을 개발할 수 있었던 기반은 1.3억 장 이상의 산업용 시각 데이터와 수년간 산업 현장에서 축적한 MLOps 기술입니다.
커스텀 비전 AI와 무엇이 다른가
| 구분 | 커스텀 비전 AI(기존) | 제로(VFM) |
|---|---|---|
| 시작 조건 | 라벨링된 학습 데이터셋 | 텍스트·이미지 프롬프트 |
| 구축 기간 | 데이터 구축+학습 수 주 | 즉시 적용 후 현장 보정 |
| 신규 객체 대응 | 데이터 수집·재학습 | 프롬프트 수정 |
| 인식 범위 | 학습한 카테고리만 | 자연어로 표현 가능한 개념 |
| 강한 영역 | 고정 조건의 극정밀 판정 | 다품종·변화가 잦은 현장 |
두 방식은 대체 관계가 아니라 조합 관계입니다. 제로가 1차 탐지와 신규 대상 대응을 맡고, 반복 검증된 핵심 공정은 커스텀 모델로 굳히는 구성이 실무 표준입니다. 이 조합의 라벨링 관점 설명은 오토라벨링 3세대 가이드에서 다룹니다.

검증된 성능: CVPR 챌린지 성적
제로의 성능은 컴퓨터 비전 분야 최대 학회인 CVPR의 국제 챌린지에서 검증되었습니다.
| 대회 | 성적 | 의미 |
|---|---|---|
| CVPR 2026 파운데이션 퓨샷 객체 탐지 챌린지 | 1위 (mAP 53.9, 2위 51.6, 베이스라인 33.3) | 7개 평가 카테고리 중 5개 1위 |
| CVPR 2025 같은 챌린지 | 4위 | 1년 만에 4위에서 1위로 |
| CVPR 2025 개별 객체 탐지 챌린지 | 2위 | 산업 현장형 특정 객체 인식 |
퓨샷 챌린지는 소수의 예시 이미지와 텍스트 설명만으로 새로운 객체를 인식하는 능력을 평가합니다. 산업 현장에서 매일 벌어지는 "처음 보는 대상 인식" 문제와 같은 구조입니다. 우승 방법론은 기술 해설 글에 공개되어 있습니다.
학습 방식도 공개되어 있습니다. 기술 논문(arXiv 2507.04270) 기준으로 제로는 10억 장 규모의 산업 데이터에서 선별한 약 90만 장으로 학습해 37개 산업 데이터셋에서 우위를 보였습니다. 데이터를 많이 쓰는 경쟁이 아니라 잘 고르는 경쟁이라는 것이 제로의 설계 철학입니다.
현장 적용: 실측 사례
| 현장 | 결과 | 방식 |
|---|---|---|
| 기계 제조(KIDD STK 2026 시연) | 1천 장 라벨링을 100장 검수로 축소 | 제로 1차 라벨 생성 후 사람 검수 |
| 제조 기업 S사 | 학습 없이 PPE 감지 가동, 준수율 98% | 제로샷 영상 관제 |
| 데이터가 부족한 신규 프로젝트 | 10장 수준의 이미지로 착수 | 프롬프트 기반 초기 탐지 |
도입 환경: 온프레미스와 엣지
제로는 Tiny(배포 파라미터 440M)·Base(500M)·Large(610M) 세 가지 크기로 제공되어 용도에 맞게 선택할 수 있습니다(상세 사양은 제품 페이지 참조). 경량 모델은 엣지 디바이스와 NPU에서 구동되므로, 민감한 산업 데이터를 외부로 전송하지 않고 현장에서 직접 처리할 수 있습니다. 폐쇄망 환경과 실시간 추론이 필요한 현장 모두 대응합니다. 클라우드로 시작하려면 AWS Marketplace의 SageMaker 엔드포인트로 바로 사용할 수 있고, 슈퍼브 플랫폼에서 바로 체험할 수도 있습니다.
최신 버전에서 무엇이 좋아졌는지는 ZERO 2.2 업데이트에서 확인할 수 있습니다.
자주 묻는 질문(FAQ)
Q. 학습을 안 했는데 우리 현장의 특수한 객체를 인식할 수 있나요?
자연어로 표현 가능한 대상이라면 1차 탐지가 가능합니다. 도메인 고유 대상은 소수의 예시 이미지(퓨샷)를 함께 주면 인식률이 올라가며, CVPR 2026 챌린지 1위가 바로 이 능력에 대한 검증입니다.
Q. 커스텀 모델을 이미 쓰고 있는데 제로가 필요한가요?
신규 객체·예외 상황 대응을 제로가 맡고 검증된 핵심 공정은 기존 모델을 유지하는 조합이 일반적입니다. 재학습 주기가 잦아 운영 부담이 큰 라인일수록 조합 효과가 큽니다.
Q. 보안이 엄격한 폐쇄망에서도 쓸 수 있나요?
온프레미스 구축을 지원하며, 경량 모델은 엣지 장비에서 구동됩니다. 데이터가 현장 밖으로 나가지 않는 구성이 가능합니다.
Q. 어떻게 시작하는 것이 좋나요?
보유 데이터가 없어도 됩니다. 대상 객체와 현장 이미지 샘플로 탐지 가능성을 확인하는 파일럿부터 시작해, 자동화 범위를 넓혀가는 순서를 권장합니다. AWS Marketplace 또는 슈퍼브 플랫폼에서 바로 확인할 수 있습니다.
함께 보면 좋은 콘텐츠
 SUPERB AI
 SUPERB AI

슈퍼브에이아이는 산업 현장의 시각 데이터를 기업이 활용할 수 있는 인텔리전스로 전환하는 비전 인텔리전스 기업입니다. 1.3억 장 이상의 산업 데이터 기반으로 산업 특화 비전 파운데이션 모델 제로(ZERO)를 개발해 제공합니다.
💬 제로 도입을 검토하고 계신가요? 아래에 탐지 대상과 현장 환경을 남겨주시면 영업 전화가 아니라 탐지 가능성 검토부터 시작합니다.