
제로샷 비전 AI: 학습 없이 시작하는 객체 인식과 산업 현장의 한계
새 제품이 나올 때마다 모델을 다시 학습시킬 필요는 없습니다. 제로샷 비전 AI의 동작 원리와 산업 현장 적용 조건을 실측 근거와 함께 정리했습니다.

📚 제로(ZERO) 시리즈 · 1. 제로(ZERO) 가이드 · 2. 제로샷 객체 인식의 원리와 한계 (현재 글) · 3. ZERO 2.2 업데이트
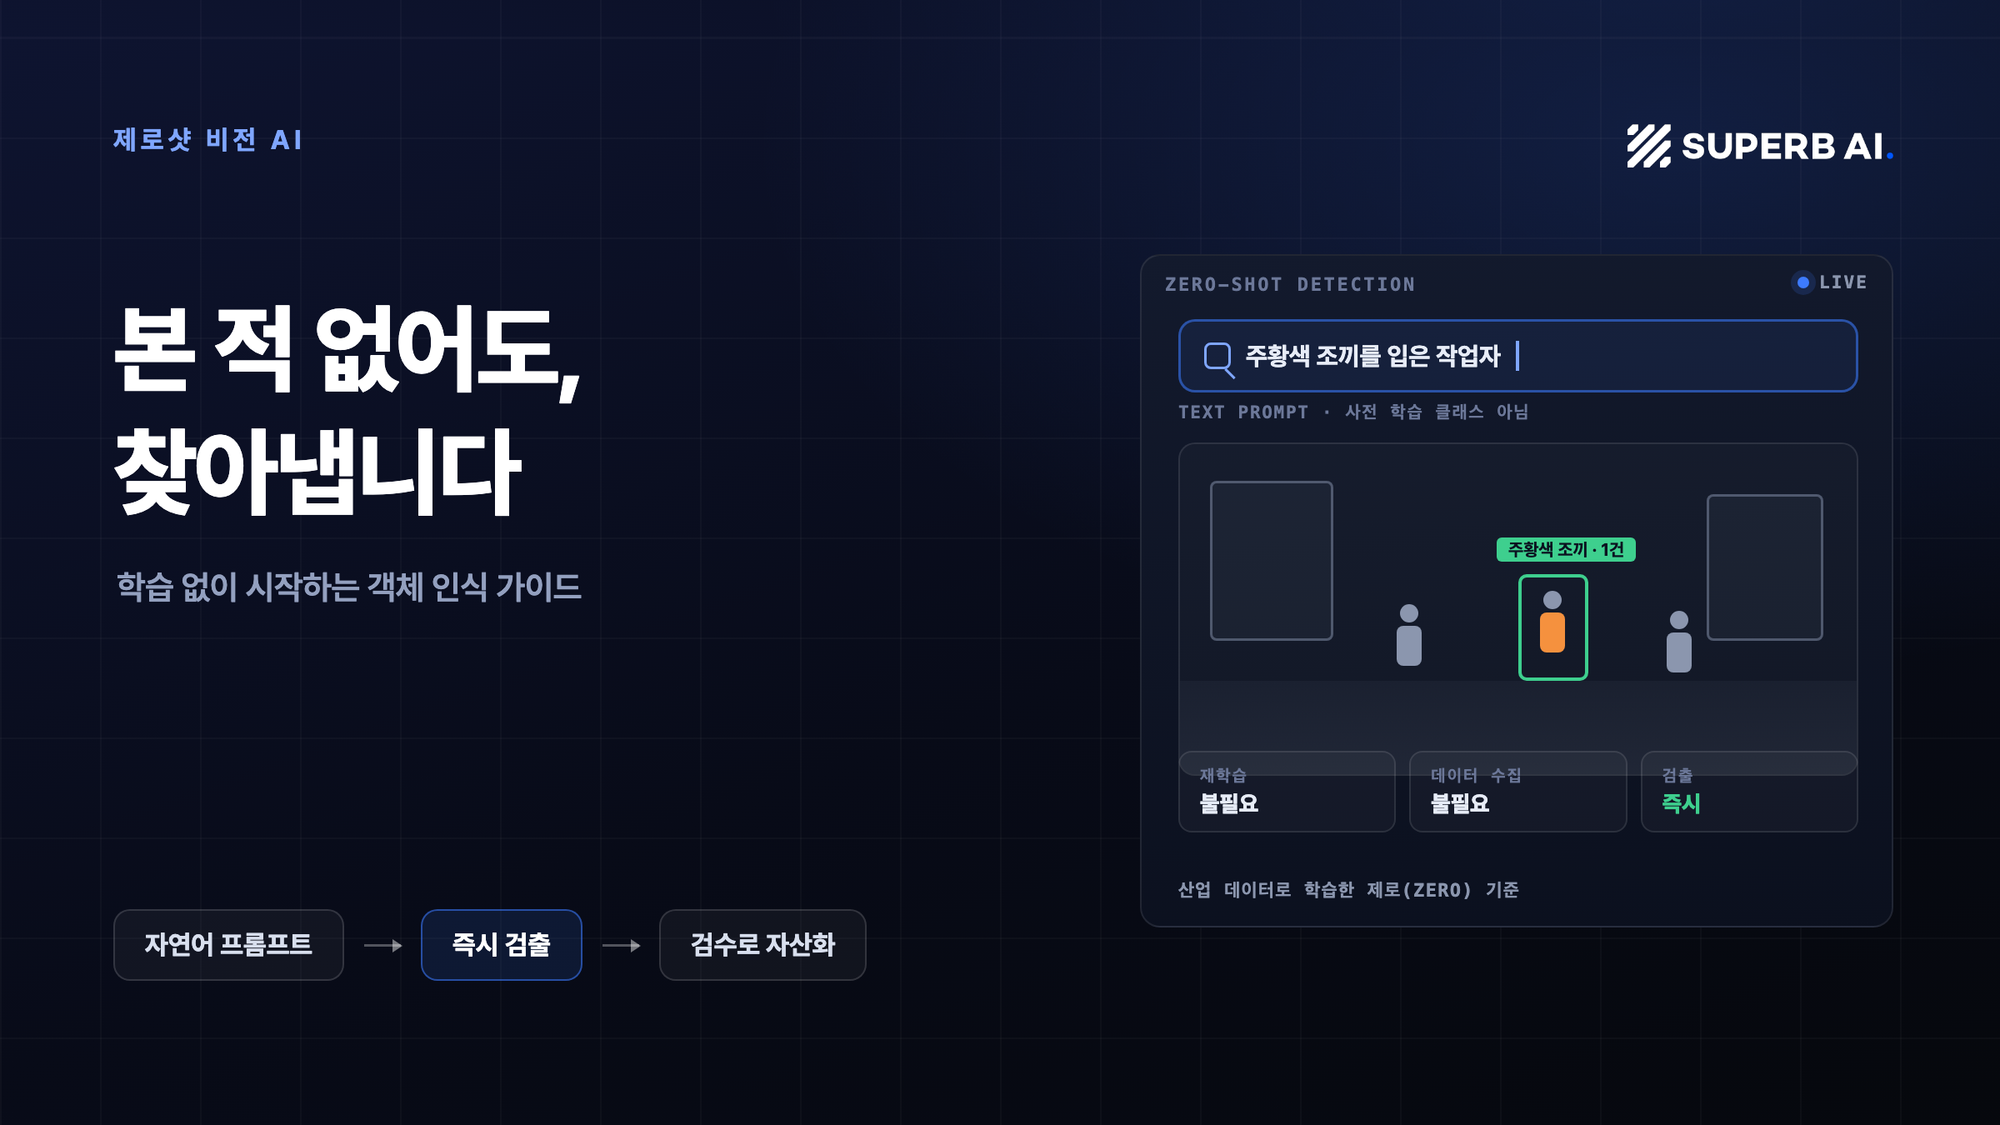
제로샷(Zero-Shot) 비전 AI는 학습 과정에서 본 적 없는 대상을 자연어 설명만으로 인식하는 기술입니다. "주황색 조끼를 입은 작업자"라고 입력하면, 그 조합을 학습한 적이 없어도 이미지에서 찾아냅니다. 이 글은 제로샷의 동작 원리와 라벨링 공정에 가져오는 변화, 그리고 일반 모델이 산업 현장에서 부딪히는 한계와 해법을 정리한 가이드입니다.
📌 3줄 요약
· 제로샷 비전 AI는 사전 정의된 카테고리 밖의 대상도 자연어로 인식하므로, 새 대상이 생길 때마다 데이터 수집과 재학습을 반복할 필요가 없습니다.
· 제로샷은 라벨링을 없애는 기술이 아니라 라벨링의 시작점을 바꾸는 기술입니다. 모델이 먼저 그리고 사람이 검수하는 오토라벨링 공정의 1차 엔진이 됩니다.
· 인터넷 이미지로 학습한 일반 모델은 산업 현장에서 성능이 떨어집니다. 슈퍼브에이아이는 산업 데이터로 학습한 비전 파운데이션 모델 제로(ZERO)로 이 간극을 좁혔고, CVPR 2026 챌린지에서 1위를 기록했습니다.
왜 AI는 매번 다시 배워야 했는가
기존 컴퓨터 비전 시스템은 폐쇄집합(Closed-set) 방식으로 동작합니다. 학습 단계에서 정의한 카테고리 안에서만 답을 고를 수 있습니다. 새 제품이 출시되거나 검사 기준이 바뀌면 이미지 수집, 라벨링, 재학습, 검증을 처음부터 반복해야 합니다. 신제품 주기가 짧은 현장일수록 이 반복이 도입의 병목이 됩니다.
작업별로 모델이 쪼개지는 문제도 있습니다. 분류, 탐지, 검사, 카운팅에 각각 다른 모델을 운영하면 한 모델이 배운 것이 다른 모델로 옮겨지지 않습니다. 같은 현장의 시각 데이터를 다루면서도 지식이 사일로에 갇힙니다.
제로샷의 동작 원리: 이미지와 언어를 같은 공간에서
제로샷을 실증한 대표 연구는 2021년 OpenAI의 CLIP입니다. 인터넷에서 수집한 4억 개의 이미지·텍스트 쌍을 대조학습(Contrastive Learning)으로 훈련해, 시각 정보와 언어 설명을 같은 표현 공간에서 연결했습니다. "빨간 스포츠카"라는 문장과 실제 빨간 스포츠카 이미지가 가까운 위치에 놓이도록 학습하는 방식입니다.
이 구조 덕분에 모델은 고정된 카테고리 목록이 아니라 자연어로 표현할 수 있는 개념 전체를 다룹니다. 이후 개방 어휘(Open-Vocabulary) 객체 탐지 연구들이 이 표현을 탐지 문제로 확장하면서, "찾고 싶은 것을 문장으로 쓰면 찾아 주는" 사용 방식이 자리 잡았습니다.
제로샷 오토라벨링: 라벨링이 사라지는 것이 아니라 시작점이 바뀝니다
제로샷이 라벨링을 대체한다는 설명이 많지만, 실무 공정은 다르게 돌아갑니다. 제로샷 모델의 출력은 그대로 학습 데이터가 되지 않습니다. 오탐과 미검출이 남기 때문입니다. 실제 공정에서 제로샷은 오토라벨링의 1차 엔진입니다. 모델이 먼저 라벨을 그리고, 사람은 그리는 작업이 아니라 검수와 보정을 담당합니다.
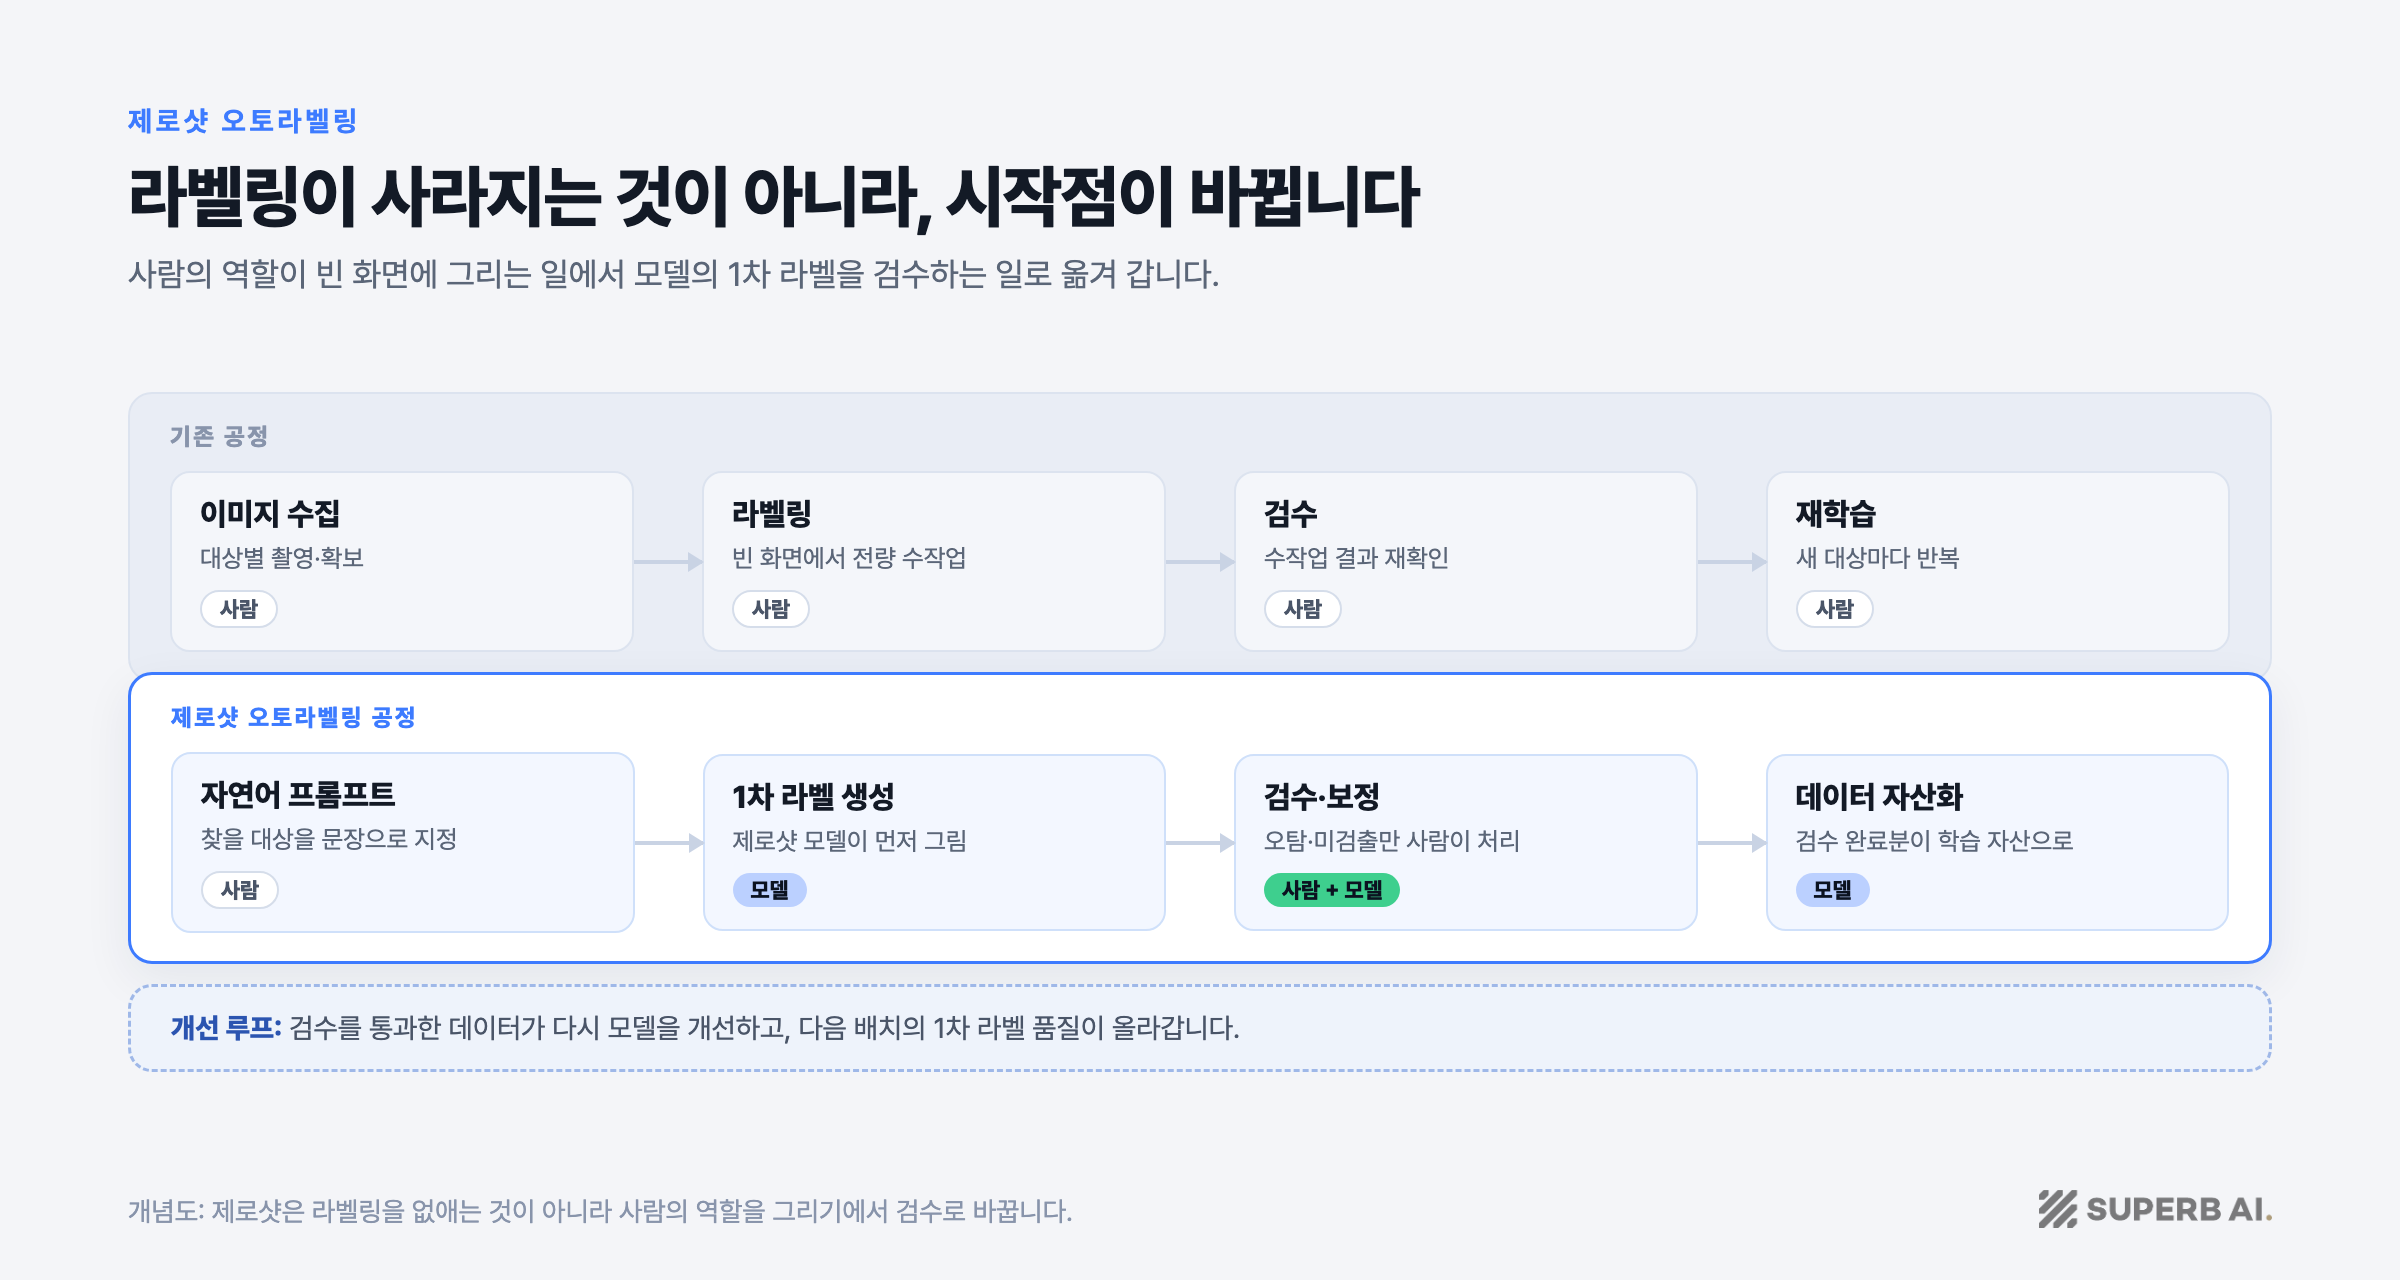
이 구조에서 바뀌는 것은 총량입니다. 사람이 빈 화면에서 시작하지 않으므로 같은 인력으로 처리하는 데이터양이 달라지고, 확보한 검수 완료 데이터는 다시 모델을 개선하는 자산이 됩니다. 오토라벨링 세대 구분과 도입 판단 기준은 데이터 라벨링 자동화 가이드에서 자세히 다뤘습니다.
일반 모델의 한계: 산업 현장은 인터넷 이미지와 다릅니다
공개 제로샷 모델의 학습 데이터는 대부분 인터넷 이미지입니다. 개, 고양이, 자동차는 잘 찾지만 PCB 기판의 미세 결함, 웨이퍼 표면 이물, 플랜트 배관의 부식은 인터넷에 충분히 존재하지 않는 대상입니다. 일반 모델을 산업 이미지에 그대로 적용하면 이 도메인 간극에서 성능이 떨어집니다.
슈퍼브에이아이가 산업 특화 비전 파운데이션 모델 제로(ZERO)를 만든 이유가 여기에 있습니다. 제로는 10억 장 규모의 산업 데이터에서 선별한 약 90만 장으로 학습해, 37개 산업 데이터셋에서 우위를 보였습니다(arXiv 논문). 성능은 외부 무대에서도 검증됐습니다. CVPR 2026 Foundational Few-Shot Object Detection 챌린지에서 mAP 53.9로 1위를 기록했고(2위 51.6, 베이스라인 33.3), 7개 산업 카테고리 중 5개에서 1위였습니다. 2025년 4위에서 한 해 만에 올라선 결과입니다.
제로샷 도입, 무엇부터 시작하나
제로샷의 장점은 시작 비용이 낮다는 것입니다. 보유한 이미지 몇 장에 프롬프트를 넣어 보는 것으로 검증이 시작됩니다. 처음 보는 대상 중 어디까지 잡히는지, 못 잡는 대상은 이미지 몇 장의 참조로 해결되는지를 확인하면 됩니다. 이미지 10장으로 시작하는 검증 절차는 산업 비전 AI 데이터 병목 해설에 정리돼 있습니다.
제로는 AWS Marketplace와 슈퍼브 플랫폼에서 제공 중입니다. 모델 상세와 라인업은 제로 제품 페이지에서 확인할 수 있습니다.
자주 묻는 질문 (FAQ)
Q. 제로샷 비전 AI란 무엇인가요?
학습 과정에서 본 적 없는 대상을 자연어 설명만으로 인식하는 기술입니다. 사전 정의된 카테고리 목록에 없는 객체도 "녹슨 배관", "안전모 미착용 작업자"처럼 문장으로 지정해 찾을 수 있습니다.
Q. 제로샷을 쓰면 데이터 라벨링이 필요 없어지나요?
아닙니다. 제로샷 출력에는 오탐과 미검출이 남으므로 검수가 필요합니다. 실무에서는 제로샷이 라벨을 먼저 그리는 오토라벨링의 1차 엔진으로 쓰이고, 사람의 역할이 그리기에서 검수로 바뀝니다.
Q. 공개 제로샷 모델과 산업 특화 모델은 무엇이 다른가요?
학습 데이터가 다릅니다. 공개 모델은 인터넷 이미지 중심이라 산업 현장의 결함·부품·이물 인식에서 성능이 떨어집니다. 산업 데이터로 학습한 모델은 이 간극을 좁힙니다. 제로는 산업 데이터 약 90만 장으로 학습해 37개 산업 데이터셋에서 우위를 보였습니다.
Q. 제로샷 성능은 어떻게 검증하나요?
공개 벤치마크와 챌린지 성적이 기준이 됩니다. 제로는 CVPR 2026 Foundational Few-Shot Object Detection 챌린지에서 1위를 기록했습니다. 도입 검증은 보유 이미지 소량으로 직접 프롬프트를 넣어 보는 방식을 권장합니다.
 SUPERB AI

 SUPERB AI


💬 비전 파운데이션 모델 도입을 검토하고 계신가요? 아래에 현장 유형과 검출 대상을 남겨 주세요. 과제 검토부터 시작합니다.
슈퍼브에이아이는 산업 현장의 시각 데이터를 기업이 활용할 수 있는 인텔리전스로 전환하는 비전 인텔리전스 기업입니다.