
“보고, 듣고, 느끼고”…멀티모달 AI, 물리 세계로 확산
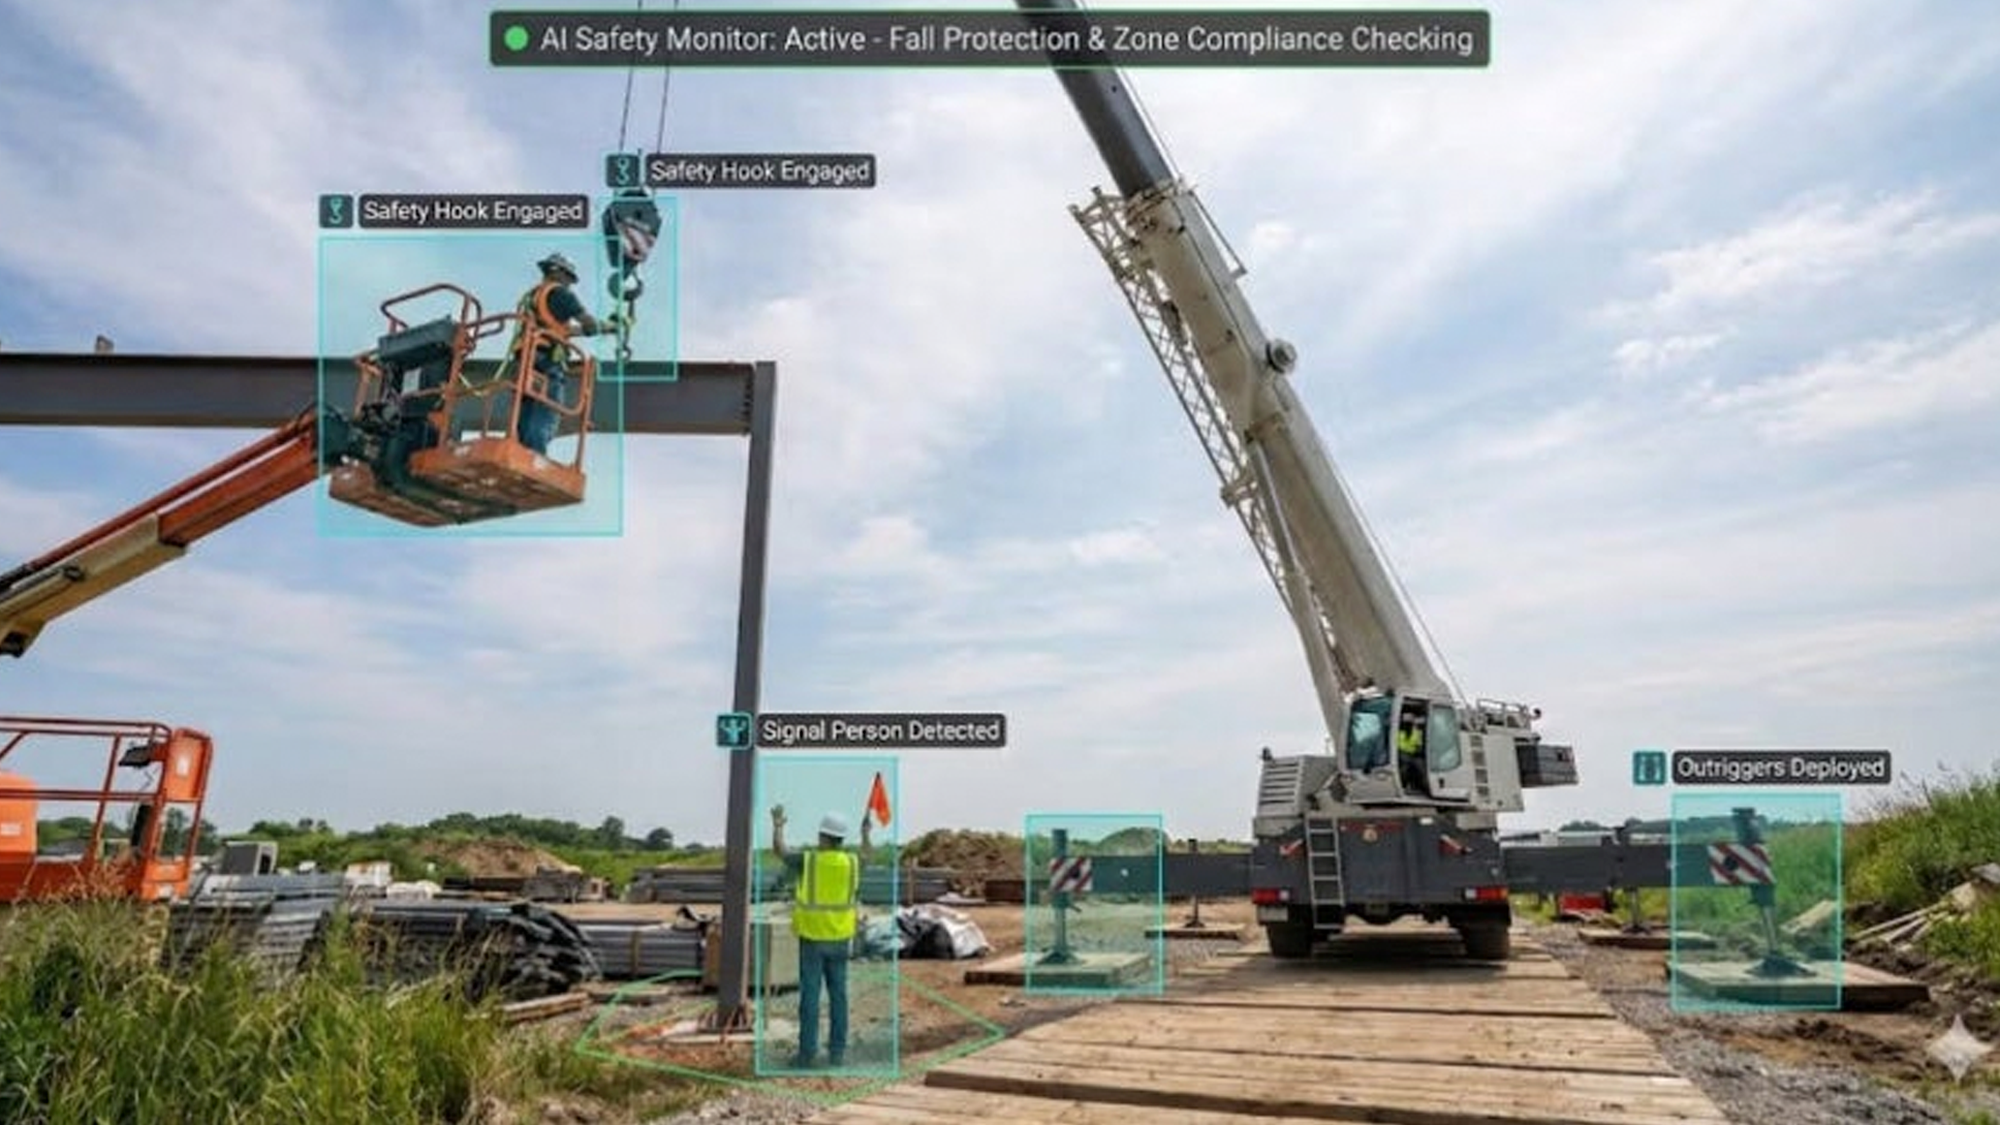
피지컬 AI에 시각·음향·촉각 등 다양한 감각 정보가 결합되고 있습니다. 슈퍼브에이아이는 LG AI연구원 컨소시엄에서 'K-엑사원'에 비전 AI를 더해 텍스트 중심 AI를 영상까지 이해하는 멀티모달 AI로 확장하고 있으며, 자연어로 객체를 찾는 비전 파운데이션 모델 '제로'를 기반으로 VLA 모델까지 제공하고 있습니다.

시각·음향·촉각 결합…AI ‘행동’으로 진화
제조·로봇 현장서 멀티모달 적용 확대
VLA·예지보전 등 피지컬 AI 고도화
인공지능(AI)이 글을 읽고 이미지를 보는 데서 더 나아가고 있다. 영상과 소리, 촉각 등 여러 정보를 함께 받아들이며 현실 세계를 이해하기 시작했다. 이런 ‘멀티모달 AI’가 로봇과 결합하면서 피지컬 AI 기술도 빠르게 진화하고 있다.
20일 정보기술(IT) 업계에 따르면 국내 AI·로봇 기업들은 시각 정보를 중심으로 발전해온 피지컬 AI에 음향과 촉각 등 다양한 감각 정보를 결합하고 있다. 로봇이 주변 상황을 여러 방식으로 파악해 더 정확하게 판단하고 행동하도록 만드는 것이 목표다.
시장도 커지고 있다. 시장조사업체 모도르인텔리전스는 글로벌 멀티모달 AI 시장이 2025년 29억9000만달러(약 4조1561억원)에서 올해 38억5000만달러(약 5조3515억원)로, 2031년에는 135억1000만달러(약 18조2229억원)로 성장할 것으로 내다봤다.
국내에서는 정부 주도 AI 사업과 산업 현장을 중심으로 적용이 확산하고 있다.
LG AI연구원 컨소시엄에 참여한 슈퍼브에이아이는 ‘K-엑사원’에 비전 AI 기술을 더하고 있다. 텍스트 중심 AI를 이미지와 영상까지 이해하는 멀티모달 AI로 확장하는 역할이다. 향후에는실제 행동까지 수행하는 비전·언어·행동(VLA) 모델로 발전시키는 것이 목표다.
슈퍼브에이아이가 개발한 비전 파운데이션 모델 ‘제로’는 자연어로 원하는 물체를 찾을 수 있다. 폐쇄회로(CC)TV 영상에 ‘헬멧을 쓰지 않은 사람을 찾아줘’라고 입력하면 대상의 위치를 찾아내는 식이다. 산업 현장의 안전 관리와 결함 검사 등에 활용되고 있다.
(중략)
멀티모달 AI가 피지컬 AI와 결합하면서 로봇이 받아들이는 정보도 다양해지고 있다. 카메라로 보는 데 그치지 않고 소리를 듣고 촉각을 느끼며 현실 세계를 이해하는 방향이다. AI가 ‘보고 듣고 이해하는’ 단계를 넘어 실제로 행동하는 흐름도 더욱 빨라질 전망이다.
모도르인텔리전스는 보고서에서 “서로 다른 데이터 간 추론 기술의 발전이 멀티모달 AI의 새로운 활용 가능성을 열고 있다”면서 “제조 현장에서도 영상과 센서 데이터를 함께 활용하면서 더 풍부한 맥락 이해와 의사결정이 가능해질 것”이라고 전망했다.