
로봇 학습 데이터를 만드는 세 갈래: 시뮬레이션 생성, 실물 수집, 순찰하며 수집
로봇에게 무엇을 보여주고 무엇을 기록해야 학습 데이터가 되는지, 지금 돌리고 있는 세 갈래 데모를 셋업과 한계까지 적었습니다. 시뮬레이션과 실물 로봇에서 나온 데이터가 각각 어떤 조건에서 나왔는지 밝혀둡니다.


로봇 학습 데이터라고 하면 실물 로봇 앞에 사람이 붙어 동작을 하나씩 시연하는 장면을 떠올립니다. 그 방식만으로는 환경과 물체를 바꿔가며 필요한 양을 모으기 어렵습니다. 저희 연구팀은 시뮬레이션에서 만드는 방식, 실물 로봇에서 모으는 방식, 로봇이 스스로 돌며 모으는 방식을 함께 실험하고 있습니다. 이 글은 그 세 갈래 데모의 셋업과 조건을 적은 기록입니다.
시뮬레이터 안에서 이미지와 정답 라벨이 함께 생성되는 원리는 앞선 글에서 다뤘습니다. 이 글은 그다음 단계인 로봇 행동 데이터, 즉 피지컬 AI(Physical AI) 모델이 학습할 에피소드를 만드는 이야기입니다.
자세히 보기 → 합성 데이터 파이프라인 구축 가이드
첫째 갈래: 시뮬레이션에서 에피소드를 만든다 (SIM)
Isaac Sim 안에서 로봇이 태스크를 수행하는 동안 관측과 행동을 에피소드로 기록합니다. 환경·태스크·물체를 바꿔가며 같은 과정을 반복하면 학습 데이터가 쌓입니다. 영상 앞부분에서 장면이 계속 바뀌는 구간이 이렇게 생성한 에피소드입니다.
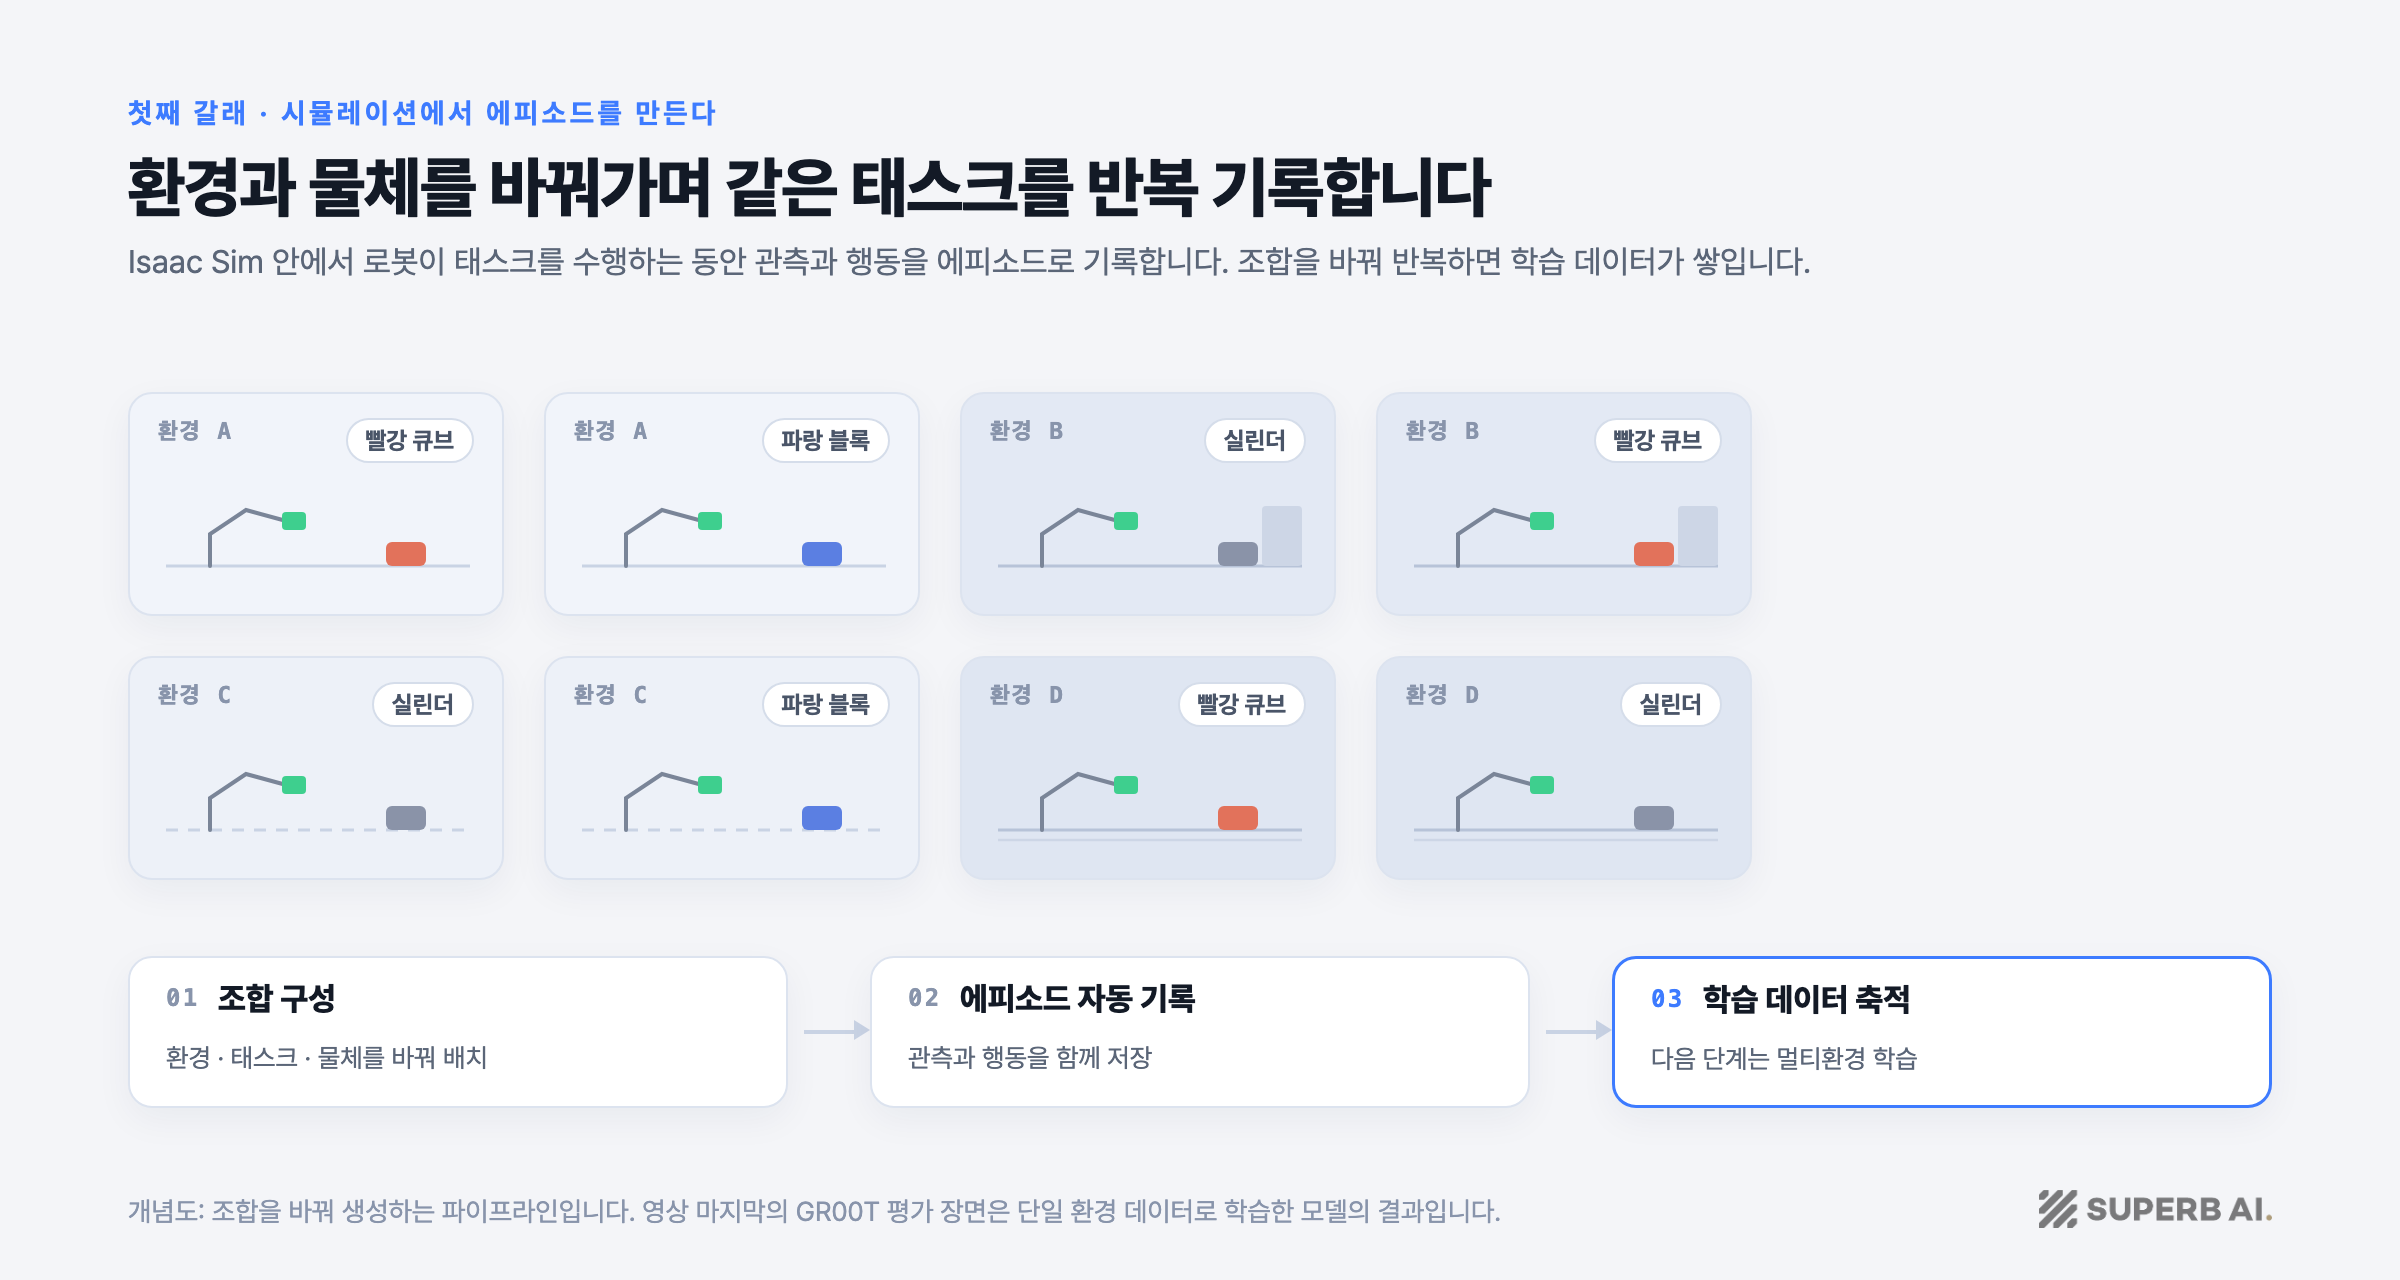
영상의 마지막 장면은 GR00T 모델이 평가에서 pick & place에 성공한 에피소드입니다. 이 모델은 위 파이프라인보다 앞선 단계에서 학습했습니다. 배경과 바닥 텍스처가 없는 단일 환경에서 빨간 큐브 하나를 다루는 에피소드 1,000개로 100k 스텝을 파인튠한 결과입니다.
환경·태스크·물체를 바꿔 생성하는 파이프라인은 그 다음 단계입니다. 빈 환경 데이터로 학습한 모델은 빨간 큐브 너머로 일반화하기 어렵습니다. 생성 파이프라인으로 수십만 건 규모의 시연을 만들어, 물체와 환경이 바뀌어도 동작하는 정책을 학습하는 것이 목표입니다. 성공률은 멀티환경 학습 결과가 나올 때 전후 비교로 함께 공개하겠습니다.
둘째 갈래: 실물 로봇에서 사람이 시연한다 (REAL)
실물 로봇에서는 사람이 원격 조작으로 시연 동작을 만듭니다. head cam과 wrist cam 영상, 로봇의 관절 상태를 동기로 기록합니다. 에피소드마다 "Pick black small cylinder into white bin" 같은 언어 지시를 하나 붙입니다. 이 묶음 하나가 학습용 에피소드 한 건입니다. 지금까지 2,500건을 모았습니다.
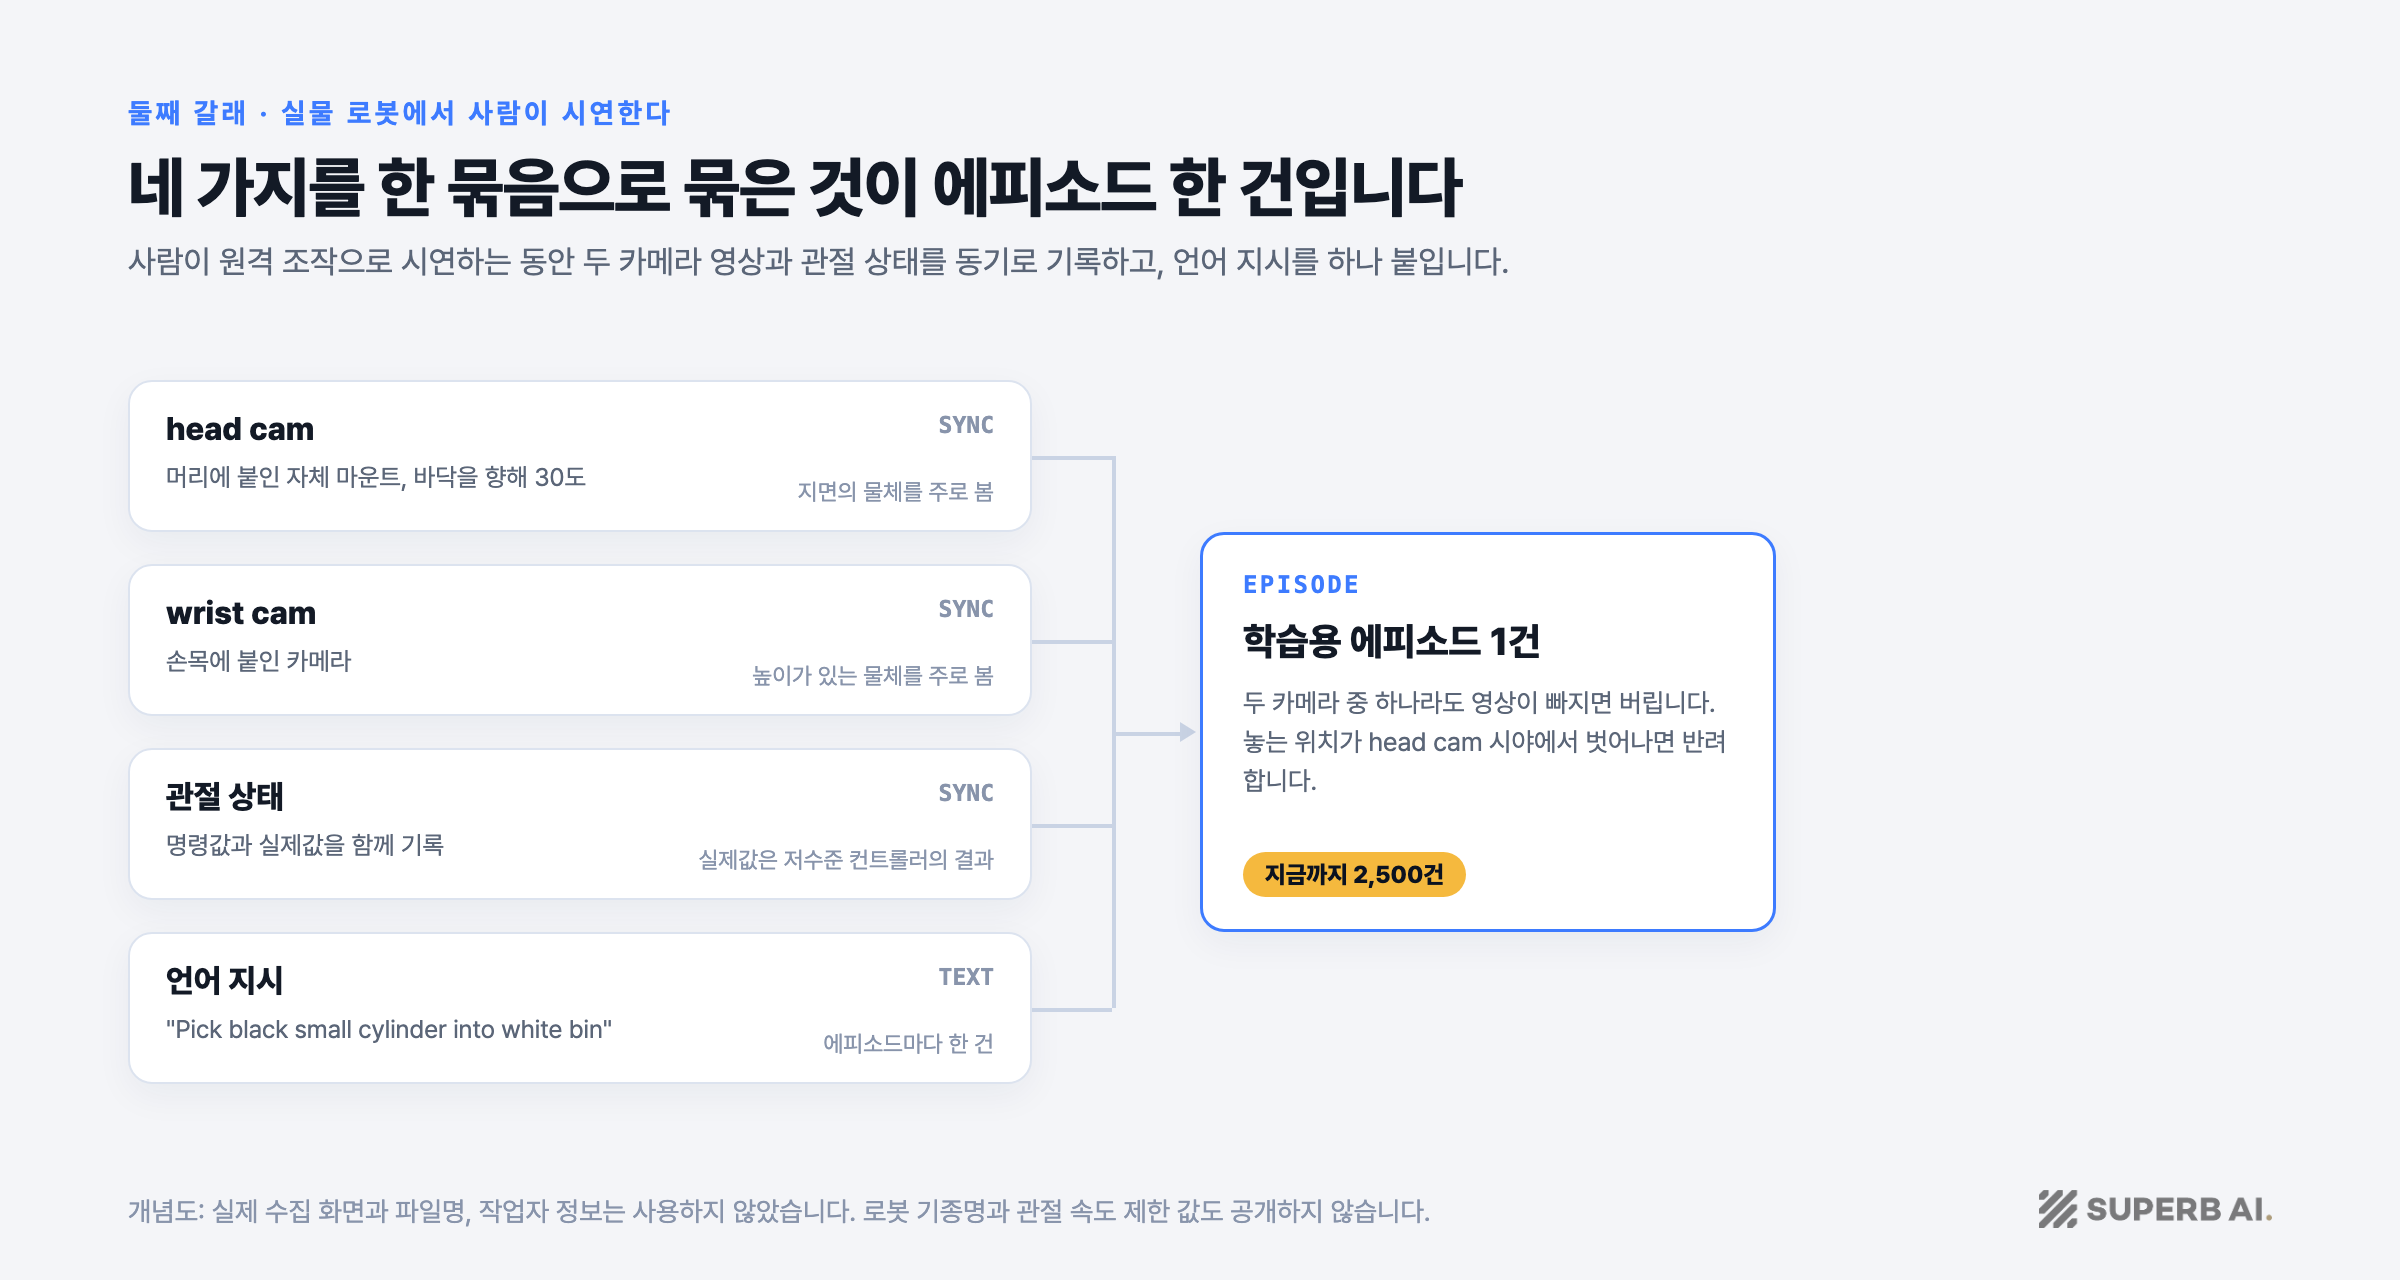
카메라 배치는 몇 차례 바꿨습니다. head cam은 자체 설계한 마운트로 머리에 붙였습니다. 바라보는 각도는 바닥을 향해 30도 정도 틀었습니다. 지면의 물체는 head cam이, 높이가 있는 물체는 wrist cam이 주로 봅니다.
기록한 에피소드를 전부 쓰지는 않습니다. 두 카메라 중 하나라도 영상이 빠지면 그 에피소드는 버립니다. 물체를 놓는 위치가 head cam 시야에서 벗어나면 그 에피소드도 반려합니다.
명령한 관절값과 실제 관절값은 어긋납니다. 실제 관절값은 로봇의 저수준 컨트롤러가 만들어내는 값입니다. 컨트롤러는 여러 제약 아래에서 명령을 따릅니다. 안전을 위해 걸어둔 관절 속도 제한이 그중 하나입니다. 추론할 때도 같은 컨트롤러 설정을 유지하면 학습과 추론의 데이터 분포가 같아지므로, 이 차이를 둔 채 수집을 이어갔습니다.
셋째 갈래: 로봇이 스스로 돌며 모은다 (SIM)
사람이 시연하지 않아도 데이터가 쌓이는 구조도 실험했습니다. Isaac Sim 안에서 4족보행 로봇이 정해진 경로를 순찰하며 waypoint마다 이미지를 저장합니다. 저장한 이미지는 순찰 로봇의 카메라 데이터로 쓰입니다. 순찰 자체가 데이터 수집입니다.
보행은 강화학습으로 학습한 정책이 맡습니다. 정책과 물리 시뮬레이션이 함께 움직임을 만들어냅니다.
목표 지점에서 팔이 병과 컵을 집는 장면은 학습 결과가 아닙니다. 타깃 포즈를 주면 cuRobo 모션 플래닝이 팔의 궤적을 계산합니다. 타깃 포즈와 데이터셋은 RoboTwin에서 가져왔습니다. 영상만 보면 집는 동작까지 학습한 것으로 읽히기 때문에, 학습된 부분과 계산된 부분을 나눠 적습니다.
세 갈래가 만나는 곳
세 데모는 같은 질문에 다른 방향에서 답합니다. 시뮬레이션은 양을, 실물은 현실의 감각을, 자율 순찰은 사람 없이 돌아가는 수집을 맡습니다. 시뮬레이션에서 만든 데이터와 실물에서 모은 데이터를 같은 학습에 쓰려면 두 쪽의 분포를 맞춰야 합니다. 실물 로봇에 걸어둔 관절 속도 제한 같은 제약을 시뮬레이터에도 같은 값으로 거는 일이 그 작업의 일부입니다.
슈퍼브에이아이는 1.3억 장 이상의 산업용 시각 데이터에 이런 로봇 행동 데이터를 더해가고 있습니다.
저희가 밝혀두는 조건
- 시뮬레이션 데이터 생성과 자율 순찰은 시뮬레이션 결과입니다. 텔레오퍼레이션 수집만 실물 로봇 결과입니다. 소제목에 SIM과 REAL로 표시했습니다.
- 첫째 갈래의 GR00T 모델은 단일 환경(빨간 큐브, 배경 없음) 에피소드 1,000개로 학습한 기준선 모델입니다. 멀티환경 생성 데이터로 학습한 결과는 아직 없습니다. 성공률은 그 결과와 함께 공개합니다.
- 팔의 pick & place는 모션 플래닝 결과이고, 학습된 정책은 보행에만 쓰였습니다.
- 실물 로봇에서 모은 에피소드는 2,500건입니다.
로봇 행동 데이터 구축을 검토 중이시라면 아래 내용을 남겨주세요. 슈퍼브 전문가가 바로 연락 드리겠습니다.
슈퍼브에이아이는 산업 현장의 시각 데이터를 기업이 활용할 수 있는 인텔리전스로 전환하는 비전 인텔리전스 기업입니다. 시뮬레이션과 실물 로봇 양쪽에서 로봇 행동 데이터를 구축합니다.